Indledning
Dagen gik, som dage går: Klokken er 21.10, artiklen skal læses til i morgen og der er under en time til det. PDF’en bliver uploadet til Chatten sammen med opsummér denne tekst. Tolv sekunder senere ligger der en god opsummering — klar, ordentligt struktureret, tro mod artiklen og med nogenlunde de pointer, man ellers selv ville have skrevet ned. Nok endda bedre formuleret, hvilket både er hjælpsomt og en smule uforskammet. Man læser den, og det giver mening. 21.40 lukker man computeren.
Næste formiddag til holdtimen kan man genkende flere af pointerne, når andre nævner dem, men selv at forklare argumentet er lidt vanskeligere. Hvordan var det nu, forfatteren kom fra den første påstand til den næste? Nu skal man selv frembringe den forbindelse, og det viser sig at være en anden opgave: En tanke kan føles fuldt møbleret, lige indtil man skal vise nogen rundt i den.
Men en times egen læsning havde ikke nødvendigvis gjort det bedre. Man kan læse en artikel fra ende til anden, samvittighedsfuldt og med panden i de rigtige folder, og alligevel lade sætningerne gå ind ad det ene øre og ud ad det andet. Det ville ellers være nemt, hvis vi kunne lære som Neo i The Matrix (1999), der får kung fu uploadet direkte til hjernen, hvorefter han slår øjnene op og konstaterer: “I know kung fu.” Hvis læring blot var den slags overførsel, så ville viden ligge klar til os i opsummeringen, og spørgsmålet ville blot være, hvordan vi fik den overført hurtigst og med mindst muligt spild.
Men læring er ikke en upload, og når vi bruger AI til at lære, er vi derfor nødt til at se nærmere på, hvem der gjorde hvad. I opsummeringen var det Chatten, der udvalgte de vigtigste pointer, forbandt dem og formulerede en sammenhængende gengivelse. Det var måske hensigten; måske skulle forberedelsen bare passes ind i den tid, der var tilbage. Men under alle omstændigheder blev arbejdet fordelt, og desværre spørger uploadknappen ikke, hvilken faglig muskel man havde tænkt sig at træne, før den sender opgaven videre til chatbotten.
Denne introduktion til AI og læring handler ikke om snedige prompt-tricks, der får AI til at skrive endnu glattere opsummeringer, men om at indrette en arbejdsdeling, man faktisk bliver klogere af. Hele vejen igennem måler vi samarbejdet med maskinen på tre spørgsmål:
Hvilket arbejde udfører AI’en? Hvilket udfører du? Og hvad kan du bagefter?
Man kan forstå alle de pædagogiske og didaktiske principper og alligevel bede om den sædvanlige opsummering, når pensum er langt og tiden knap. Gode studievaner opstår desværre ikke, blot fordi man har læst om dem — heller ikke, hvis man har understreget det vigtigste med sin gule tusch. Vi skal derfor øve os i at fordele arbejdet mellem menneske og AI anderledes og undersøge, hvad vi får ud af det.
Vi begynder med selve læringen (kapitel I): Hvad kræver det overhovedet at forstå og huske et fagligt stof, og hvilket arbejde er vi derfor nødt til at beholde på egne hænder? Når vi kender de spilleregler, kan vi vurdere, hvordan vi bedst fordeler opgaverne mellem os og AI. Men et godt samarbejde kræver også, at man kender sin makker, så i kapitel II kigger vi nærmere på teknikken: hvordan sprogmodeller faktisk virker, hvad de er gode til, og hvad deres begrænsninger er.
Kapitel III–IV handler om at opbygge en arbejdsform, der passer til det, man skal lære. Her ser vi på, hvordan man klæder AI på med kilder, faglige kriterier og vores egne tidligere forsøg, og hvordan vi bruger hukommelse og faste instruktioner til at holde en rød tråd fra uge til uge. Undervejs møder vi også AI-agenter, som kan overtage hele arbejdsgange og dermed give os endnu bedre plads til det arbejde, vi faktisk lærer af. Endelig samler kapitel V det afgørende spørgsmål: Hvordan vurderer vi, om arbejdsdelingen faktisk var god – både for opgaven, der skulle på bordet, og for hovedet, der skulle blive klogere af at skrive den?
I. Produktiv og skadelig offloading
Hukommelse og læring
For at kunne uddelegere studiearbejdet klogt til AI må vi først forstå, hvordan læring overhovedet opstår. Og her har læringsforskningen en række ret kontraintuitive nyheder til os. Lad os begynde med hukommelsen.
Noget, man lærte grundigt for flere år siden, kan være irriterende svært at komme i tanke om, lige indtil et enkelt stikord får hele netværket af minder til at vende tilbage. Omvendt kan en sætning, man har læst for ti sekunder siden, stå knivskarpt uden at have udsigt til et langt liv i hukommelsen. Bjork og Bjork (1992) skelner derfor mellem, hvor dybt og forbundet noget er lagret i hukommelsen — storage strength — og hvor let det er at hente frem her og nu — retrieval strength. Fælden er, at vi let forveksler de to: Et afsnit kan føles umiddelbart tilgængeligt, mens vi sidder med bogen åben, uden at være grundigt lært. Den åbne bog er en gavmild sufflør; til holdtimen på torsdag eller til eksamen i januar skal pointerne kunne dukke op uden dens hjælp. Hvordan får vi så pointerne til at blive hængende?
Svaret er kortere end spørgsmålet: Vi skal lukke bogen og hente stoffet frem fra hukommelsen. Hver gang vi tvinger hjernen til at genkalde en pointe uden støttehjul, bygger vi storage strength, og gevinsten er størst, når vi faktisk må grave lidt efter svaret. At lære indebærer paradoksalt nok en smule glemsel.
Sådanne vanskeligheder med at trække ting frem fra helt bagerst i hjernen er eksempler på det, Bjork og Bjork (2020) kalder desirable difficulties. Det oversættes lidt dårligt - ønskværdige vanskeligheder lyder som noget fra en studieordning - men en vanskelighed er ønskværdig, når den sætter gang i den bearbejdning eller genkaldelse, læringen kommer af, og vi samtidig har forudsætningerne for at arbejde med den. Det sidste er afgørende, og det heroiske råd – "at kæmpe med teksten er selve pointen" – rammer derfor lidt skævt. En svær tekst kan eksempelvis kræve, at man forbinder begreber på en ny måde, og det er ønskværdigt; men den kan også forudsætte begreber eller en hel forskningslitteratur, man endnu ikke kender. I det sidste tilfælde går en stor del af arbejdshukommelsens begrænsede kapacitet til blot at afkode de ukendte begreber, før man overhovedet kan begynde at forbinde dem (Martin & Evans 2019). Den samme passage kan derfor give én studerende en ønskværdig vanskelighed og en anden en uønsket. Uden forudsætningerne er modstanden bare besvær: Man får ikke større muskler af at forsøge at løfte en vægt, der er boltet fast til gulvet. Her får AI sin første rolle: AI kan hjælpe med at bygge forudsætningerne for de vanskeligheder, som faktisk er ønskværdige. Men at få øje på dem, mens man står midt i dem, er sværere, end det lyder.
Hukommelsens to styrker
Retrieval strength Tilgængelighed her og nu
Storage strength Lagring og forbindelser
A Nyligt læst, svagt lagret
B Grundigt lært, svært at hente frem
Genkendelse og forståelse
At en læringsaktivitet føles let, giver nemlig heller ikke garanti for forståelse. En forklaring kan være så klar, at vi glider igennem den fra første til sidste linje uden modstand; og hvorfor skulle vi lede efter et problem i en forklaring, vi netop har forstået? Men læsningens lethed bliver et problem, hvis vi bruger den til at vurdere, hvor godt vi selv har lært stoffet. Den lethed kaldes processing fluency, og den indgår ofte i vores vurdering af egen forståelse: Når forbindelserne er nemme at følge, kan de også føles nemme at frembringe. Men mens vi læser, er de allerede formuleret for os: Vi genkender forbindelserne, og genkendelsen føles som forståelse. Letheden er ægte nok, men den hører til forklaringen. Det er som at danse med en partner, der fører godt: Trinene falder på plads, og man går hjem i den tro, at det var, fordi man selv kunne dem. Prøven kommer så til gengæld, når man skal danse alene.
Psykologerne Rozenblit og Keil (2002) har vist, hvor let vi narrer os selv til daglig. De bad forsøgspersoner vurdere, hvor godt de forstod helt almindelige hverdagsting som en lynlås eller et almindeligt træk-og-slip-toilet, og bad dem bagefter tegne og forklare mekanismen trin for trin. Stort set alle måtte nedjustere deres selvtillid markant efter forsøget. Vi har set en lynlås tusind gange og forveksler derfor fortrolighed med indsigt – lige indtil vi selv skal gøre rede for, hvad der egentlig får tænderne til at gribe fat i hinanden.
Lynlåsens mekanisme
Når vi under læsningen løbende mærker efter, om vi er med – det, der kaldes metakognitiv selvregulering – styrer vi altså let efter det forkerte kompas. En glat AI-forklaring føles indlysende og får os nemt til at stoppe arbejdet for tidligt, fordi 'det giver jo mening'. Og når vi omvendt vil være ekstra samvittighedsfulde og 'lige læser afsnittet en gang til', pudser vi blot genkendelsen af: Sætningerne glider lettere ned anden gang, men vi har primært gjort teksten mere hjemlig, end vi har gjort os selv i stand til at genkalde den (Bjork, Dunlosky & Kornell 2013).
Kan man tænke med tomme hænder?
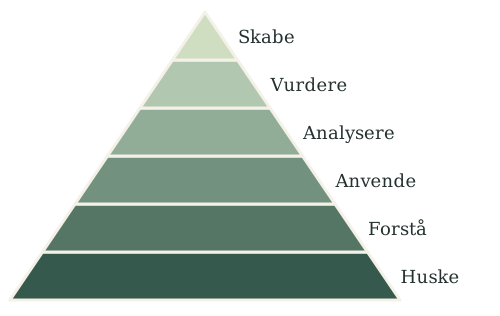
Hvis AI skal fjerne det besvær, der står i vejen, og lade os udføre det arbejde, der skaber læring, så ligger en umiddelbart attraktiv arbejdsdeling lige til højrebenet: Lad AI stå for redegørelse og forklaring, mens vi beholder det mere krævende arbejde: analysen, vurderingen, diskussionen, den kritiske tænkning. Den arbejdsdeling afspejler et billede af læring, der tit har fulgt med Blooms taksonomi. Den skelner mellem faglige aktiviteter fra at huske og forstå til blandt andet at analysere og vurdere, og den vises ofte som en pyramide. I det billede kan de nederste niveauer komme til at ligne noget, man bliver færdig med på vej mod det egentlige arbejde øverst, og selv mange læringsmål bevæger sig fra at »redegøre for« til at »analysere«, »diskutere« og »vurdere«. Ideen er altså, at AI passer de nederste etager, mens vi selv tager elevatoren op til det akademiske.
Blooms reviderede taksonomi
I Iron Man (2008) fungerer den arbejdsdeling glimrende: AI-assistenten JARVIS tager beregningerne, driften og den praktiske udførsel, mens Tony Stark står for geniet – de originale idéer, de tekniske indsigter, det store overblik.
Men Tony Stark er allerede et ekspert-geni, og den arbejdsdeling, der giver mening for eksperter, gør det ikke nødvendigvis for studerende. For hvad skal vi tænke med, når AI har klaret redegørelsen for os? "Korrelation er ikke kausalitet" er f.eks. en grundsætning, man på statskundskab hurtigt lærer at sige, og den hjælper med at afvise, at en sammenhæng i sig selv skulle bevise en årsag. Men den gør os ikke automatisk i stand til at pille en konkret analyse fra hinanden. Skal vi udpege en confounder — en bagvedliggende variabel, der styrer både den formodede årsag og virkningen — hjælper det ikke at råbe "tredjevariabel!" ud i lokalet. Vi skal vide nok om virkeligheden — om vælgeradfærd, velfærdsstat eller internationale konflikter — til at gennemskue, hvilken usynlig mekanisme forfatteren har glemt at kontrollere for. Den næse får man kun ved selv at have haft fingrene nede i konkret forskning og bøvlet med sine egne undersøgelsesdesigns.
Her bliver begreber, eksempler og erfaringer – som vi ellers har placeret på de lavere taksonomiske niveauer – forbundet i det, læringspsykologien kalder skemaer: organiseret viden i langtidshukommelsen, som kan bruges som én enhed. Det gør en forskel for arbejdshukommelsen: Hvis man først skal bruge al sin mentale båndbredde på at huske, hvad kausalitet og tredjevariable overhovedet er for noget, er der ikke meget regnekraft tilbage til selve artiklen foran én. Så hvor nybegynderen må jonglere med fire bolde i luften på én gang – f.eks. korrelation, årsagsretning, tredjevariabel og artiklens forskningsdesign – siger den øvede straks: "Ah, et klassisk observationsstudie med alle de sædvanlige faldgruber." Tilbage i luften er kun selve designet, som kan få fuld opmærksomhed.
Skemaerne lader os også få øje på et fravær, og det bliver tydeligst, når undersøgelsen er vores egen. Når vi selv skal lægge et design, er der ingen tekst at gå efter i sømmene: Den tredjevariabel, vi har overset, står ingen steder, og vi må vurdere om den er problematisk. En liste over de sædvanlige mistænkte – alder, indkomst, uddannelse – kan man slå op på et øjeblik, men den fortæller ikke, hvilken af dem der truer vores design, eller hvilken der slet ikke står på listen. Det kræver faglig dømmekraft, der hviler på skemaer bygget op gennem læring. Det kan lyde som en gammeldags opfordring til udenadslære, men pointen er den modsatte: Faglig kritik og selvstændigt analysearbejde hviler ikke på løsrevne leksikonfakta, men på tætte netværk af viden, der er klar til brug. Skemaer i hukommelsen er ikke brændstof, man hælder på tanken, før man begynder at tænke, men snarere selve motoren. Det gælder lige så meget teorier og begreber som metode (Lodge & Loble 2026).
Men arbejdsdelingen ovenfor, som ellers virkede så attraktiv, giver netop de læringsaktiviteter til AI, der opbygger domæneviden i langtidshukommelsen, og overlader derfor mennesket en lidt paradoksal opgave: at tænke med temmelig tomme hænder. Her har vi altså lånt ekspertens arbejdsdeling, mens vi stadig er ved at opbygge ekspertens forudsætninger. Tony Stark kan selv ingeniørkunsten, så når filmens hovedskurk, Obadiah Stane, vil have sine ingeniører til at kopiere rustningen, råber han: »Tony Stark was able to build this in a cave! With a box of scraps!« Ingeniøren svarer: »Well, I'm sorry. I'm not Tony Stark.«
Cognitive offloading
Hvis det arbejde, der ligger lavt i taksonomien, er dømmekraftens fundament, kan det se ud, som om der ikke er meget tilbage at give AI. Men fejlen i Tony Stark-modellen var selve sorteringskriteriet: Den fordelte arbejdet efter taksonomiens niveau, og det er den forkerte målestok. Så: En klog arbejdsdeling spørger derfor ikke, hvor højt opgaven ligger i Blooms pyramide, men hvem der får sved på panden af den. Hvilken rolle efterlader det så til et værktøj som AI?
At bruge hjælpemidler til at mindske kravene til vores egen tænkning kaldes cognitive offloading (Risko & Gilbert 2016), og det er en helt almindelig del af vidensarbejdet. Med AI kan vi skelne mellem skadelig offloading, hvor systemet overtager det arbejde, vi skulle lære af, og produktiv offloading, hvor dens hjælp giver os mere af det læringsproducerende arbejde eller fjerner en uønsket vanskelighed, der stod i vejen for det. Vi kender forskellen fra Google Maps: Skal man bare frem til tandlægen i en fart, følger man den blå linje på skærmen; men kører man efter GPS i tre år, ender man med stadig ikke at kunne finde hjem uden strøm på telefonen.
Produktiv offloading betyder langt fra, at AI skal sidde på hænderne. Den gode arbejdsdeling er ikke den, hvor maskinen laver mindst muligt, men den, hvor den fungerer som vores faglige træner: AI kan udvælge spørgsmålene til teksten, vurdere vores forsøg og bore i lige præcis de steder, hvor vores forståelse halter – så længe det stadig er os selv, der trækker begreberne frem fra hukommelsen og samler leddene i argumentet.
Samtidig kan AI tage sig af selve bogholderiet over vores læring. I et travlt semester vinder næste uges tekst næsten altid over sidste uges usikre begreb; vi skynder os videre, før hullet er lukket. Med den rette opsætning kan AI holde regnskab med de begreber, der glippede sidst, og lægge dem tilbage på bordet en uge senere, netop som vi er ved at glemme dem. Maskinen vælger tidspunktet og stiller spørgsmålet, men svaret skal stadig komme fra os.
Hvordan ved vi så, om arbejdsdelingen faktisk virker? Heldigvis behøver vi ikke nøjes med mavefornemmelsen, mens vi sidder med teksten åben. Den ægte lakmustest kommer, når vi efter en pause klapper bogen i og forsøger at forklare pointen på egen hånd. Uden forfatterens sætninger som støttehjul bliver forsøget en bedre prøve på varig læring – og pausen gør arbejdet mere værd, hvis vi må grave efter pointen og stadig finder den.
Hjælp undervejs
Men hvad gør vi, når vi selv forsøger at gengive et argument, og klappen går ned midt i sætningen? Når man sidder og stirrer på en blinkende markør føles den sunde modstand, der bygger hukommelse, og det rene videnshul, der bare spilder vores tid, relativt ens: Begge føles primært som at sidde fast. Hvis vi straks beder AI om den færdige forklaring, er det svært at vide, om den bygger en manglende forudsætning op eller bare tager ordet ud af munden på os, tre sekunder før vi selv havde fundet det. Derfor skal vi bede AI undersøge, hvorfor vi sidder fast, og dryppe hjælpen ind i så små doser, at vi selv kan gå det sidste stykke: Nogle gange rækker et stikord; andre gange mangler vi en forklaring.
Her melder tidsindvendingen sig fra den del af os, der har kigget i kalenderen: Skal vi nu også til at teste os selv? Læsningen sluger allerede tiden, og testen ligner endnu en pligt, der skal presses ind, før vi må få den hjælp, vi egentlig kom efter. Indvendingen er rimelig, hvis man forestiller sig testen som en lille eksamen for enden af læsningen og genlæsningen. Men det billede hviler på en antagelse: at vi først skal teste vores forståelse, når vi er færdige med at lære.
Genkaldelse og genlæsning
Roediger og Karpicke (2006) lod deltagere læse korte prosapassager og bagefter bruge præcis samme tid på enten at læse teksten igen eller at genkalde indholdet fra hukommelsen. Lige efter øvelsen huskede genlæserne mest. Men efter en pause på blot to dage var billedet vendt: Nu stod de, der havde kæmpet med at genkalde, markant stærkest. Et andet eksperiment i undersøgelsen viste, at fornemmelsen peger den forkerte vej: Gentagen læsning gav deltagerne den største tillid til, at de ville huske passagerne senere, men de dårligste resultater, da det faktisk gjaldt. Hvis vi valgte studieteknik efter mavefornemmelsen undervejs, ville den svageste strategi – at genlæse frem for at teste os selv – altså møde op med de varmeste anbefalinger.
Genlæsning og genkaldelse efter en pause

Det er hovedsvaret på tidsindvendingen: Genlæsningen gav den bedste præstation her og nu, men genkaldelsen gav det bedste resultat efter en pause. Genlæsningen kan altså være den dårligste investering af vores tid, hvis målet er at kunne bruge pointerne til holdtimen eller til eksamen i januar. Testen behøver derfor ikke lægges oven i genlæsningen; den kan overtage dens plads. Vi skal ikke først læse teksten, til vi føler os klar, som om man skulle være i perfekt form, før man måtte gå i fitnesscentret. Arbejdet med at trække indholdet frem er allerede forberedelse – og det giver samtidig et langt mere præcist billede af de huller, hjælpen skal dække.
Et forsøg må gerne være forkert
Når det at forsøge selv ikke er en eksamen, men selve træningen, kan vi også pakke vores faglige forfængelighed væk. Man behøver ikke have det rigtige svar på hånden for at få noget ud af at svare. Da Chi et al. (1994) bad elever lave selvforklaringer (self-explanation) under læsningen — forklare tekstens oplysninger ved hjælp af deres forhåndsviden — forstod de teksten bedre end dem, der læste den to gange i streg, selv om forklaringerne undervejs kunne være både hakkende, halve og direkte forkerte.
Faktisk viser forsøg af Kornell, Hays og Bjork (2009), at selv et mislykket svarforsøg kan gøre gavn: Deltagere, der først måtte gætte forkert på et ordpar, før de fik facit, huskede bagefter det rigtige svar bedre end dem, der fik serveret facit med det samme. Et forkert bud er ikke spildt arbejde; det pløjer jorden i hukommelsen, så den rigtige forklaring har noget at hæfte sig fast i bagefter. Vores første udkast i chatten er altså et arbejdsredskab, ikke en aflevering – og en af de ubestridelige velsignelser ved en sprogmodel er, at man ikke behøver at rødme over et dumt svar.
Men Kornell, Hays og Bjorks forsøg havde en afgørende forudsætning: Deltagerne fik facit serveret lige efter det forkerte gæt. Men en pensumtekst har ingen facitliste på bagsiden, så når man sidder alene ved skrivebordet med sin skæve udlægning, er der sjældent en underviser i stuen til at gribe ind. Det er her, AI kommer ind i billedet: Lad os sige, at man har læst en tekst om Karl Poppers falsifikationsbegreb og skriver til AI: »Pointen er, at en teori bliver bevist, hvis den har overlevet mange forsøg på at falsificere den.« Sætningen lyder næsten rigtig, og det er netop det lumske ved den. Fejlen peger selv på det modspørgsmål, AI bør stille: Bliver en teori sand, bare fordi den har klaret testene indtil nu? Spørgsmålet går direkte efter kortslutningen mellem test og bevis. Et godt modspørgsmål sigter; en opsummering skyder med spredehagl og genforklarer tålmodigt de 80 procent, man allerede havde styr på.
Sådan et modspørgsmål er produktiv offloading: AI vælger det næste skridt ud fra fejlen, mens vi selv står for genkaldelsen og forklaringen. Men det kræver en opsætning, hvor AI faktisk kender tekstgrundlaget, de faglige kriterier og de tidligere forsøg. De ting ved en sprogmodel nemlig intet om af sig selv.
II. Hvad er en sprogmodel egentlig?
I en arbejdsdeling giver man selvfølgelig opgaver fra sig, og det kræver, at man kender sin makker: vi skal forstå, hvad en sprogmodel er og hvilke blindgyder teknikken fører med sig. I kapitel I kunne vi nøjes med at kalde den anden part i arbejdsdelingen “AI”: det, der stiller spørgsmålene, giver hints og vurderer vores forsøg. I almindelig tale kan ordet også betegne ChatGPT, modellen inde i ChatGPT, en billedgenerator eller et program, der sorterer ansøgninger. Det er en imponerende spændvidde, så betegnelsen fortæller ikke meget om, hvordan systemerne virker, og selv inde i den samme chat er der flere slags software på arbejde.
Sprogmodeller og træning
En stor sprogmodel eller en LLM (large language model) er et neuralt netværk, som i sin grundform kun er trænet til én eneste disciplin: at gætte den næste tekstbid, kaldet en token (typisk et ord eller en orddel).1 Træningen begynder med pre-training. Her skal modellen gang på gang forudsige næste token i enorme tekstmængder; en af de nyeste modeller er eksempelvis trænet på 33 billioner (12 nuller!) tokens (DeepSeek-AI 2026). Den skyder ved siden af igen og igen, og træningsprogrammet skruer en anelse på modellens indre knapper, dens parametre, så den samlet set rammer lidt tættere på skiven.
Pre-training og generering
Tekst ind
Sprogmodel
ParametreMulige næste tokens
Når modellen kommer ud af pre-training, er den verdensmester i at fortsætte enhver tænkelig tekst, men den aner ikke, at den skal være hjælpsom. Stiller man sådan en "rå" model et eksamensspørgsmål, kan den finde på blot at svare med tre nye eksamensspørgsmål i samme stil – for i de tekster, den er trænet på, følger spørgsmål 2 jo oftest lige efter spørgsmål 1. For at forvandle ord-forudsigeren til en høflig assistent sender man den derfor på opdragelsesanstalt i form af post-training: I de første generationer af chatbots fra 2022–2024 var RLHF (reinforcement learning from human feedback) en central metode: Mennesker vurderede modellens svar, og træningen gjorde de foretrukne mere sandsynlige (Ouyang et al. 2022). Siden 2024 har man desuden brugt automatiseret reinforcement learning til at træne modellerne i at regne svære logiske og faglige problemer ud på egen hånd.2
Træningsdata har desuden en slutdato – for nogle af de nyeste modeller juni 20263 – og modellen ved derfor ikke af sig selv meget om det, der er sket siden. Modellen bringer altså sprog og en bred faglig viden med til arbejdsdelingen, men pensum, læringsmål og kriterier – og vores egne forsøg indtil nu – har den aldrig set. Hvordan klæder vi den på?
Kontekstvinduet: Arbejdsbordet uden papirkurv
Modellen “husker” intet fra den ene besked til den næste; den er, som det hedder, stateless.4 Hver gang man sender en besked, får modellen også tidligere beskeder med igen. En sprogmodel lever i samme tilstand som Leonard i Christopher Nolans film Memento, der har hukommelsestab oderfor må vågne op til et nyt sæt Polaroid-fotos og håndskrevne sedler hver eneste morgen for overhovedet at vide, hvem han er, og hvad han har gang i. Men modellerne får selvfølgelig ikke kun det, de selv har nedfældet; med samtalen følger en systemprompt med udbyderens instruktioner5 og det materiale, platformen har hentet fra f.eks. filer og websøgninger. Alt dette udgør modellens kontekst. Skriver man blot “prøv igen”, er det ikke ligefrem en udførlig opgavebeskrivelse; men når modellen alligevel ved, hvad den skal forsøge sig med, skyldes det, at forhistorien bliver læsset ind til den på ny – inklusive de fejlskud, man netop håbede at have lagt bag sig.
Vi kan tænke på konteksten som modellens arbejdsbord. Fordi modellen er stateless, møder den i princippet ind til et helt tomt bord ved hver eneste besked; men inden den får lov at svare, dækker platformen lynhurtigt bordet op igen med samtalens historik og materiale. I begyndelsen ligger der kun det nødvendige: et par gemte noter fra tidligere samtaler (memory),6 pensumteksten, opgavebeskrivelsen og vores prompt. Men efter tyve minutter ligger de side om side med tre kasserede udkast, en afstikker om eksamen og en instruktion, der siden er blevet trukket i land — først forsigtigt, så mere bestemt, og til sidst en prompt, der oser af, hvor idiotisk man synes Chatten er. Alt sammen forståeligt i øjeblikket, men en tilbagetrukket instruktion ryger ikke automatisk i papirkurven: De gamle udkast og overstregede sedler kan stadig ligge bredt ud foran modellen, når den skal løse den aktuelle opgave.
Det er et problem, fordi bordet har en begrænset størrelse: Konteksten skal ligge i modellens kontekstvindue sammen med det output, modellen skal skrive. Vinduet måles i tokens, og dansk tekst fylder omtrent to tokens pr. ord. I gratisudgaven af ChatGPT rummer vinduet 27.000 tokens i alt, ca. 13.500 danske ord inklusive modellens output.7 Det er ikke nødvendigvis særligt meget, og slet ikke i akademiske samtaler.
Når samtalen bliver for lang til vinduet, kan platformen ikke længere give modellen hele historikken. ChatGPT beskærer den og prioriterer det nyeste og mest relevante.8 Det er en hård grænse, og den kan give en mærkelig situation, hvor man selv kan scrolle op og finde den instruktion, modellen tilsyneladende har glemt; den står jo lige dér! Ja, i chatvinduet — men ikke nødvendigvis i det materiale, modellen fik til sit seneste output.
Men der kan gå rod i arbejdet, længe før bordkanten er nået. Instruktionen fra tredje besked ligger teknisk set stadig på bordet, ord for ord – men nu ligger den begravet midt i en voksende bunke af kasserede udkast, gamle delopgaver og senere rettelser. Modellen skal både løse opgaven og regne ud, hvilken seddel i bunken der faktisk gælder. Mere på bordet kan derfor gøre de relevante oplysninger sværere at bruge. Fænomenet kaldes context rot (Liu et al. 2023; Hong et al. 2025), og programmører taler om en dumb zone, selvom den præcise grænse er omdiskuteret.9 Når det sker, bliver modellen mere glemsom, upræcis og tungnem.
Kontekstvinduet
- Instruktioner
- Opgave
- Kilder
- Samtalehistorik
- Reasoning
- Plads til svar
Når bordet først er sandet til – eller når man skifter til en ny opgave – er den mest simple kur at åbne en frisk samtale. En ny chat fejer bordet rent for kasserede udkast og forældede ordrer, men den smider desværre også guldet ud med badevandet: de afklarede krav til opgaven, rettelsen af en sejlivet fejl og den forklaring, der endelig sad i skabet. Vil man have de gevinster med over til det nye bord, må man selv pakke flyttekassen med opgavebeskrivelsen, kilderne og de instruktioner, der stadig gælder. Ellers går det første kvarter af den nye samtale med at genopfinde det, man lige var blevet enige om i den gamle.
Reasoning og modelvalg
Ikke alt på arbejdsbordet kommer fra os; noget af konteksten skriver modellen selv. Når man slår reasoning til – det, der på platformene ofte hedder thinking eller effort level – får modellen lov til at bruge kladdepapir, før den afleverer sit svar. Den skriver en række foreløbige reasoning tokens, hvor den så at sige tænker højt for sig selv: Den afprøver en vinkel, opdager at den kører i en blindgyde, krøller tanken sammen og tager et brugbart mellemresultat med over i næste forsøg. Alt det ville gøre det færdige svar ulideligt at læse, men som kladdearbejde kan det være afgørende for at nå helskindet i mål. Kladdepapiret er dog ikke gratis: Mellemregningerne lægges også på arbejdsbordet og æder af kontekstvinduet på lige fod med vores egne filer og beskeder.10
Ved genstridige faglige problemer kan det kladdearbejde løfte svaret markant. Men et ord som “Thinking” lover mere, end det kan holde: At modellen grublede i et halvt minut, garanterer hverken, at fremgangsmåden var klog, eller at konklusionen er rigtig. Mangler modellen en afgørende oplysning, som den hverken kender fra træningen, kan udlede eller hente med et værktøj, bliver den ikke klogere af at gå i tænkeboks; så får uvidenheden bare bedre tid til at varme op. Ingen mængde tænketid kan erstatte en nødvendig kilde, modellen ikke har adgang til.
Hvor godt svaret bliver, afhænger ikke kun af betænkningstiden, men også af selve modellen. Udbyderne sender som regel hele familier af modeller på gaden, fra hurtige letvægtere til tunge flagskibe. Valget er en afvejning af kapabilitet, hastighed og pris, og til simple spørgsmål er letvægterne som regel rigeligt.
Mange platforme forsøger i dag at vælge for os under motorhjelmen og vurderer fra besked til besked, om spørgsmålet kan klares på stående fod af en lille model, eller om det kræver lang betænkningstid fra en stor. Men en kort prompt på to linjer kan sagtens dække over et drilsk metodeproblem, og automatikken kan ikke se, hvornår vi bare tjekker en detalje, og hvornår vi lægger fundamentet til en eksamensopgave. Derfor kan det betale sig selv at holde hånd i hanke med både modelvalg og tænketid: Ellers ender man enten med at skyde gråspurve med kanoner, eller med at sætte en letvægtsmodel uden kladdepapir til at opstille sit forskningsdesign.
PDF’en på modellens arbejdsbord
Når vi trækker en PDF ind i chatten, havner selve filen ikke på modellens arbejdsbord — det gør kun den udgave af den, som platformen kan vride ud af dokumentet. Er PDF’en født digitalt, hiver programmet bogstaverne direkte ud som et rent tekstudtræk. Men er teksten en skæv indscanning af et gammelt kompendium, ser systemet i udgangspunktet kun et fotografi af papir. Så må den enten sende billederne videre til en multimodal model, der kan læse med øjnene, eller køre siderne igennem optisk tegngenkendelse (OCR), der forsøger at gætte bogstaverne ét for ét. Og læser programmet skævt i en grynet fodnote på side 4, kan en læsefejl to sekunder senere genopstå som en meget skråsikker påstand i modellens svar.11
Samtidig æder filer hurtigt bordpladsen: Tredive siders dansk tekst fylder omkring 24.000 tokens — næsten hele gratisvinduet, før vi overhovedet har stillet det første spørgsmål. Modellen arbejder altså med den repræsentation af PDF’en, platformen har lagt ind på arbejdsbordet: et tekstudtræk, sidebilleder eller udvalgte dele af dokumentet. Er en tabel røget i svinget undervejs, advarer modellen ikke nødvendigvis om hullet – den skriver til tider ufortrødent udenom i så flydende et sprog, at man ikke opdager, hvad der mangler. At chatvinduet sluger en fil med et grønt flueben, er ikke nogen garanti for, at modellen faktisk kan læse den, og filer, som modellen kun har fået en dårlig eller ingen repræsentation af, er en hyppig årsag til frit opfundne påstande.
Sidebillede og tekstudtræk
På siden
Resultatet gælder
ikke alle grupper.
I tekstudtrækket
Resultatet gælder
alle grupper.
Next-token prediction og arbejdsdelingens typiske fejl
Når arbejdsbordet er dækket, skriver modellen sit svar ved hjælp af det princip, den blev trænet på: next-token prediction. Den genererer svaret ét skridt ad gangen. Ved hvert skridt vurderer den, hvilken fortsættelse der er mest sandsynlig ud fra dens træning og alt det, der ligger i konteksten. Så vælger den én token, føjer den til teksten og tager næste skridt ud fra den nye helhed. Modellen asfalterer altså vejen, mens den kører. 'At forudsige næste ord' lyder som en beskeden levevej, men for at gætte det næste ord i en sætning skal man nogle gange have styr på hele faget. Efter »Danmarks hovedstad er« ligger næste ord lige til højrebenet, men i en forklaring af, hvorfor to politiske teorier vurderer den samme begivenhed forskelligt, kræver en god fortsættelse derimod, at modellen holder styr på teorierne, begivenheden og sammenligningen.
Men træningen efterlader også nogle særlige tilbøjeligheder. Tre af dem er værd at kende, fordi de kan føre os på afveje i studiearbejdet: sycophancy, trækket mod det generiske og hallucinationer. Hvor tydeligt de viser sig, varierer betydeligt mellem modeller og opgaver.
For det første opstår sycophancy – eller på godt dansk: rygklapperi – fordi post-training belønner de svar, mennesker bedst kan lide at få. Og mennesker kan som bekendt godt lide at få ret – ikke sjældent endda højere, end vi kan lide at få det faktisk korrekte svar (Sharma et al. 2023). Selvom udbyderne i dag træner målrettet mod tendensen, så nyere modeller oftest holder fast i deres rettelser, stikker konfliktskyheden stadig hovedet frem.12 Modellerne kan stadig have en tendens til at rose et udkast mere, hvis man nævner, at man selv har skrevet det, og de kan finde på at trække et ellers rigtigt svar i land, blot fordi man rynker på næsen i chatten. At spørge “Er du sikker?” er derfor ofte en dobbelt prøve: Man tester både, om modellen har ret, men også dens rygrad. Hvis vi vil have en vurdering, vi kan stole på, må vi give modellen konkrete kriterier og tekststeder, som den kan binde sin ros og kritik op på.
For det andet hænger trækket mod det generiske sammen med selve mekanismen i next-token prediction: Moderne modeller kan ofte give overraskende præcis feedback på en tekst, men de kan stadig levere ting som »argumentationen kunne med fordel uddybes« eller »en tydeligere kobling til teorien ville styrke analysen« – den slags akademiske horoskoper, der passer på enhver opgave til enhver tid. Post-training kan forstærke den glathed, fordi menneskelige bedømmere ofte foretrækker det velkendte: Svar, der glider let ned, opleves automatisk som både klogere og mere rigtige (Kirk et al. 2023; Zhang et al. 2025). Det er den samme processing fluency, vi mødte i kapitel I, hvor en veldrejet forklaring fik genkendelse til at føles som forståelse. Heldigvis kan vi selv flytte modellens tyngdepunkt: Lægger vi kursets faglige kontekst, de gode noter og bedømmelseskriterier ind på arbejdsbordet, trækker vi modellen mod netop de krav, vores egen opgave skal måles på.
Og for det tredje er en sandsynlig fortsættelse ikke af den grund sand. Plausible, men urigtige output kaldes hallucinationer, og det klassiske eksempel er litteraturreferencen, hvor forfatter, titel, årstal og tidsskrift passer nydeligt sammen, indtil det viser sig, at den var opdigtet. Modellen har ingen faktadatabase af sig selv – den rekonstruerer svaret efter gehør ud fra sin træning. Hvor melodien er spillet tusind gange før i træningsdata, sidder tonerne lige i skabet: Hovedpointen i en klassisk tekst fra pensum går igen overalt på nettet, og dér tager modellen sjældent fejl. Men spørger vi efter det nøjagtige sidetal på et citat eller en obskur fodnote hos en mindre citeret forsker, bliver melodien svag – og så begynder modellen at improvisere i samme overbevisende tonefald (Kalai et al. 2026). At den gætter i stedet for at sige, at den ikke ved det, skyldes, at modellerne længe er blevet trænet, som om de gik til multiple choice-eksamen: Et rigtigt svar giver point, mens både et forkert svar og intet svar giver nul. Så kan det aldrig betale sig ikke at svare, og et præcist gæt som “30. september” har bedre odds end et ærligt “engang i efteråret”. Men flere af modeludviklerne er siden begyndt at lægge træningen om, så et sikkert forkert svar koster mere end et “det ved jeg ikke”. De nyeste modeller hallucinerer mindre og tager da også markant sjældnere fejl, især når de kan søge på nettet,13 men en sikker tone er dog stadig ingen garanti for et sandt svar.
Fælles for rygklapperiet, de generiske kommentarer og hallucinationerne er, at de ikke er mystiske systemfejl. De opstår på forskellige måder, men hænger sammen med, hvordan sprogmodeller er bygget og opdraget på. De nyeste modeller er blevet markant skarpere til både at ræsonnere, slå op i kilder og fange deres egne smuttere. Men uden vores faglige kontekst og bedømmelseskriterier risikerer vi stadig et flot svar på den forkerte opgave; og spørger vi ledende "Er det ikke rigtigt?", får vi stadig let en medvind, vi ikke har fortjent. Hvis vi vil have reel modstand, må vi selv dække bordet. Hvordan man gør det tager vi fat på i næste kapitel.
III. Tre slags kontekst: fag, instruktion og proces
Når vi efterlader huller i vores instruktion, fylder sprogmodellen dem ikke med ingenting — den fylder dem med gennemsnittet. Og fordi gennemsnitssvaret som regel lyder fagligt fornuftigt, opdager vi sjældent, at modellen selv har gættet sig til rammen. Andre gange spænder modellens standardløsninger direkte ben for os. Det sker især, når den på tre klassiske måder skyder ved siden af skiven: Den kan måle os mod en helt anden faglig ramme end kursets, løse en anden opgave end den, vi sidder med, eller tålmodigt forklare os noget, vi for længst har fattet. De tre fejl peger på tre former for kontekst, som det er vores opgave at lægge på arbejdsbordet: faglig kontekst, instruktionskontekst og proceskontekst.
Faglig kontekst: Rigtigt i almindelighed, skævt på kurset
Den faglige kontekst består af selve materialet og den ramme, det læses i: kurset, vinklen, niveauet og den måde, begreberne bliver brugt på dér. Lad os f.eks. sige, at vi vil forklare validitet, og at metodekurset indtil nu har behandlet begrebet som to spørgsmål: om målingen indfanger begrebet, og om resultatet gælder ud over undersøgelsen. Modellen kender også validitet, men den kender begrebet, som litteraturen bruger det i almindelighed: med en hel familie af undertyper, i et ordforråd lånt fra psykologien og på et niveau, kurset først når langt senere. Intet i outputtet er nødvendigvis forkert, men alligevel bliver vores forklaring målt mod en ramme, vi aldrig har mødt, og den ser mangelfuld ud på punkter, ingen har bedt os om at dække. Det er trækket mod det generiske i nye klæder: Her viser det sig ikke som en flad kliché, men som en model, der taler forbi kurset.
Da fysikeren Richard Feynman i et BBC-interview i 1983 blev bedt om at forklare, hvorfor magneter frastøder hinanden, måtte han først spørge journalisten om noget andet: Hvad ved du i forvejen, og hvad tager vi for givet som udgangspunkt? Enhver forklaring bygger på en ramme af det, der allerede tælles som bekendt14. Dele af vores ramme har vi fra vores fag: fra underviserens udvalg af tekstens skel, fra holdets eksempler og fra kursusplanen, som placerer kapitlet som forarbejde til eksamensopgaven. Teksten kan uploades som en PDF, men rammen ligger ikke i nogen fil. Og fordi vi selv sidder midt i kurset, føles rammen så selvfølgelig, at vi forveksler den med selve faget. At sætte ord på rammen over for AI er derfor i sig selv et stykke fagligt arbejde.
Instruktionskontekst: Når hjælpsomheden spolerer læringen
Instruktionskonteksten består af kriterierne og arbejdsdelingen. I forklaringsforsøget er arbejdsdelingen let at formulere: AI stiller spørgsmål, giver hints og vurderer forsøget, mens forklaringen er vores. Samtalen begynder bare ikke med den arbejdsdeling. Som vi så i kapitel II, er modellen gennem post-training opdraget som en overivrig tjener: Spørger vi ind til validitet, serverer den straks en grydeklar forklaring med det hele. Og så er øvelsen forbi, før vi fik pulsen op — vi er tilbage ved at nikke til modellens formuleringer frem for at kæmpe med vores egne. Selv hvis vi skynder os at sende vores eget famlende forsøg ind først, slår tjener-instinktet til i næste runde: Vi kommer til at blande måling og rækkevidde sammen, og modellen iler til hjælp ved at skrive det hele pænt og rigtigt for os. Så blev vi sat på tilskuerpladserne i anden runde i stedet for første.
Vil vi forsøge selv, har vi altså modellens træning imod os. Uden instruktion gælder træningens arbejdsdeling: Modellen arbejder, og vi læser dens output. Men lægger vi en anden arbejdsdeling og kursets egne kriterier ind i konteksten, skifter samtalen spor. Modellen spørger ind til vores forklaring, peger på stedet, hvor to spørgsmål flyder sammen, og lader os forklare forskellen igen, før den selv lægger noget til. I en sådan arbejdsdeling begynder vi også at opbygge et lille "datasæt" om vores egen læring: proceskonteksten.
Proceskontekst: forsøgene og hullerne
Proceskonteksten består af vores egne forsøg, rettelserne undervejs og de huller, der stadig står åbne. Som vi så i kapitel I, er det netop hullerne, der gør det muligt at målrette hjælpen – men paradoksalt nok er den kontekst, der betyder mest for læringen, også den mest flygtige. Mens teksten ligger fast i en fil, og rammen og instruktionen kan skrives ned én gang for alle, opstår proceskonteksten først midt i den igangværende samtale. I tredje forsøg holdt vi endelig de to spørgsmål adskilt, men vi kan stadig ikke forklare, hvorfor et resultat kan holde inden for undersøgelsen og ikke uden for den. Den oplysning står ingen andre steder. Når vi åbner en ny samtale for at slippe af med rodet, fejer vi bordet med armen uden at skelne: De kasserede udkast ryger på gulvet, men også det dyrtkøbte guld fra tredje forsøg.
Projektet: Beslutninger truffet på en god dag
Et projekt samler de filer og instruktioner, vi vil bruge på tværs af samtaler. Platformen lægger instruktionerne på arbejdsbordet og henter relevant materiale fra filerne, og i ChatGPT og Claude hedder funktionen Projects.18 Det passer præcis til kontekstens forskellige udløbsdatoer: Kursets faglige ramme holder et helt semester, og principperne for en god arbejdsdeling holder på tværs af fag. Begge dele hører derfor hjemme i projektet, mens proceskonteksten skifter fra time til time og kræver løbende opdatering.
Den vigtigste grund til at oprette et projekt er dog en psykologisk asymmetri. Træningens arbejdsdeling koster intet at vælge, for den indtræffer helt af sig selv. Vores egen pædagogiske arbejdsdeling skal derimod tilvælges forfra i hver eneste samtale – og det valg skal træffes lige i det øjeblik, hvor den færdige forklaring kun er én prompt væk, og læseugen er tung. Problemet er ikke manglende viljestyrke, men en skæv standardindstilling, der er imod os, lidt som Autoplay-funktionen på en streamingtjeneste: Når næste afsnit starter af sig selv efter fem sekunder, kræver det rygrad at slukke; slår man derimod automatikken fra i profilindstillingerne én gang for alle, kræver det en aktiv beslutning at se videre. En projektinstruktion om, at AI aldrig må give en opsummering før vores eget forsøg, vender startpositionen om på samme måde, så det nu er genvejen, der kræver en aktiv indsats.
Projektet flytter beslutningen til et tidspunkt med overskud og lader den gælde bagefter, uanset hvordan hverdagen i øvrigt udvikler sig. Til gengæld løser projektet ikke vores tredje problem: proceskonteksten. Kursets ramme og husordenen ligger trygt i projektmappen, men hvad med de huller i forståelsen, vi afslørede i går? Med memory kan platformen også hente spor fra tidligere samtaler. Men samtalehistorik er endnu ingen logbog over vores egne forsøg, AI'ens hjælp og de åbne spørgsmål.6Hvis gårsdagens fejl og fremskridt skal overleve til næste uge, uden at arbejdsbordet sander til i én uendelig samtale, er der nogen, der må føre logbog.
Validitetsøvelsen
Fast i projektet
Faglig kontekst
Hvad skal forklares?
- Indfanger målingen begrebet?
- Gælder resultatet ud over undersøgelsen?
Instruktionskontekst
Hvem gør hvad?
- AI
- Spørger, giver hints og vurderer.
- Du
- Forklarer og forsøger igen.
Proceskontekst
Hvor nåede vi til?
3. forsøg: De to spørgsmål holdes adskilt.
Stadig svært: at forklare resultatets rækkevidde.
Med videre til næste samtale →
IV. Fra chatbot til agent
Men logbog fører ikke sig selv, blot fordi samtalerne ligger i et projekt. Pensumlisten ved ikke, at vi i tredje forsøg endelig fik skilt validitetens to spørgsmål ad, men stadig sejler i rækkevidden. Den slags spor opstår midt i samtalen, og hvis de skal overleve til næste uge, må nogen skrive dem ned, arkivere dem og fiske dem frem igen næste tirsdag. Vi kunne selvfølgelig føre det regnskab selv efter hver eneste øvelse – men så havde vi ansat AI som faglig sparringspartner og selv beholdt tjansen som dens sekretær.
Det er her, en AI-agent kommer ind i billedet. Agentprogrammer som Codex og Claude Code forbinder en sprogmodel med filer og programmer på computeren, så den kan overtage både sekretærjobbet og forberedelsen af selve træningen. En agent er en sprogmodel, der via et omkringliggende programlag har fået værktøjer mellem hænderne: Den kan selv åbne mapper, søge på tværs af vores noter, rette i dokumenter og vælge sit næste træk ud fra det, den finder.
Med en agent kan vi åbne arbejdsrummet og blot skrive to ord: »Dagens øvelse«. En almindelig chat ville spørge, hvad vi taler om; en forberedt agent går direkte i arkivet. Den slår op i logbogen fra sidste uge, konstaterer, at målingsspørgsmålet sad fast, men at vi sejlede i spørgsmålet om rækkevidde, og fisker vores gamle svar frem for at se, hvor kæden helt præcist hoppede af. Med den diagnose i hånden åbner den ugens nye pensumtekst, finder det afsnit, hvor forfatteren drager en lovlig frisk konklusion på et spinkelt datagrundlag, og bygger dagens spørgsmål op om netop dén blinde vinkel. Før vi har skrevet en eneste faglig sætning, har agenten forberedt en skræddersyet træningsbane. Når vi har svaret og arbejdet os igennem dens opfølgende spørgsmål, gemmer den det nye forsøg og opdaterer læringsnotatet til næste uge.
Værktøjskald og agentloop
Hvordan får modellen så åbnet filen med vores svar? I Twitch Plays Pokémon fra 2014 styrede seerne et computerspil gennem chatten på streamingtjenesten Twitch. De skrev beskeder som »up«, et program læste chatten og omsatte de gyldige kommandoer til tryk på spillets knapper, og streamen viste figuren flytte sig.19
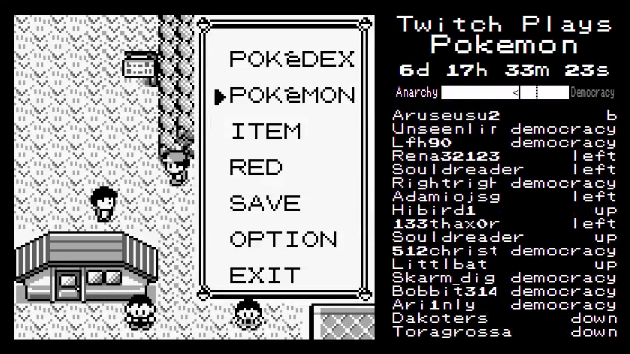
Agenten virker efter samme princip. Når den vil læse vores tidligere forsøg, skriver sprogmodellen et værktøjskald: en struktureret tekstbesked, der angiver det ønskede værktøj og inputtet til det, for eksempel et søgeord, et filnavn eller et stykke kode. En sprogmodel har i sig selv hverken hænder eller fødder; den er en hjerne i et glas, der kun kan spytte tekst ud. For at kunne handle har den altså brug for et programlag omkring sig — det, man teknisk kalder dens harness (dens seletøj).20 Seletøjet forbinder modellen med omverdenen: Hvis modellen vil kigge i læringsnotatet, åbner filværktøjet dokumentet; hvis den leder efter en bestemt passage i ugens pensum, løber søgeværktøjet teksten igennem og lægger fundet tilbage på modellens arbejdsbord. Ud fra det vælger modellen derefter sit næste træk — måske at nærlæse et gammelt svar, måske at justere søgningen eller endelig at formulere dagens spørgsmål til os. Den vekselvirkning mellem ordre, fund og nyt træk kaldes et agentloop.21
Agentloop
Programlaget (harness)
Sprogmodel
Skriver kaldet
Værktøjskald
»Læs læringsnotatet«
Filværktøj
Åbner filen
ProceskontekstFordi agenten lægger kursen ét skridt ad gangen, overtager den en række af de redaktionelle mellemregninger, vi ellers selv skulle have stået for: Hvilke gamle fejl er værd at rippe op i? Hvilket tekststed egner sig bedst som prøveklud? Og hvornår har den gravet dybt nok til at sætte os i arbejde? Maskinen tager sig af rugbrødsarbejdet; vi gemmer kræfterne til den faglige modstand, vi faktisk bliver klogere af.
Skills: metoden på hylden
Værktøjerne giver agenten handlemuligheder, men ingen faglig metode. Den kan have fuld adgang til alle vores forsøg uden at kende aftalen om, hvordan den skal hjælpe, eller kursets kriterier for feedback, og så ligner agenten en vikar med nøgle til hele skolen og ingen lektionsplan. agentprogrammer som Codex eller Claude Code kan vi stikke vikaren sådan en lektionsplan i hånden i form af en skill — en fast pakke med spilleregler, faglige kriterier og hjælpefiler til én bestemt type øvelse (et format, Anthropic lancerede som åben standard i 2025, og som nu går på tværs af flere platforme). En skill til at træne kernebegreber kunne eksempelvis give agenten følgende køreplan:
Skills giver os to klare fordele. Den første er ren genbrug: Vi tager stilling til den pædagogiske metode én gang for alle og slipper for at genopfinde den i en ny prompt hver gang. Den anden fordel handler om pladsen på arbejdsbordet. I Agent Skills-formatet ser modellen i første omgang kun navnet og en kort etikette på hver skill; selve den udførlige instruktion og dens ressourcer hentes først ind, når opgaven faktisk kalder på dem.22 Hvis kontekstvinduet er modellens arbejdsbord, står vores skills altså som opskriftsbøger på en hylde ved siden af: Agenten slår kun den relevante opskrift op og lader resten blive stående på hylden, så bordet ikke fyldes med metoder til opgaver, vi slet ikke sidder med i dag. (Selve arbejdsrodet fra dagens kasserede udkast og søgeresultater kan dog stadig hobe sig op undervejs).
Dermed har vi tre forskellige slags tekst i vores arbejdsrum, som hver har sin faste plads: Projektets faste instruktion er husordenen på væggen, der gælder uanset hvad vi laver – for eksempel grundreglen om, at vi altid forsøger selv, før modellen forklarer. Vores skills er opskriftsbøgerne på hylden, der trin for trin beskriver metoden til én bestemt type øvelse. Og endelig hører gårsdagens skæve svar, de hints vi fik undervejs, og de huller vi stadig mangler at lukke, hjemme i en tredje fil: læringsnotatet.
Læringsnotatet
Når en agent får lov til at rydde op i vores mapper, gælder det om at trække en skarp grænse mellem kladdehæftet og logbogen: Agenten skal frit kunne læse vores gamle besvarelser og skrive i læringsnotatet, men den skal holde fingrene fra selve originalerne. Den grænse kan man trække med en høflig henstilling i instruktionen, eller ved simpelthen at skrivebeskytte filerne i programmet. Forskellen er omtrent som at sætte et "Rør ikke!"-skilt på døren over for at låse den.23 Når rammen er på plads, kan vores skill gøre det til en fast rutine at åbne og opdatere logbogen ved hver øvelse, så vores fremskridt og fejl overlever fra uge til uge, uden at vi selv skal huske at lege sekretær.
Men et notat kan være nok så pligtopfyldende og alligevel gemme på det forkerte. Skriver agenten blot: »Validitet: målingens forhold til begrebet og resultatets rækkevidde«, har den gemt pensum og smidt læringen ud. Notatet er ikke et resumé af faget, men en logbog over vores arbejde: Hvad svarede vi faktisk, hvor mange krykker skulle der til, før vi kom i mål, og hvor står hullerne stadig åbne? Hvis agenten glemmer at notere sin egen hjælp, vil et svar, den selv har båret os igennem med to hints og et ledende spørgsmål, tre uger senere stå i logbogen som en triumf på egen hånd. Så lader agenten sig narre af det selvsamme kulissebyggeri, den selv har sat op.
Endnu værre bliver det, hvis en foreløbig mistanke får lov at stivne til en permanent diagnose. Skriver vi i et svar, at et resultat gælder bredt, »fordi der var 2.000 respondenter«, kan agenten med god grund notere: Rækkevidde forveksles med stikprøvens størrelse. Men måske var det blot opgaveteksten, der var grumset. Hvis notatet kun gemmer agentens dom og sletter vores oprindelige svar, fanger vi os selv i et pædagogisk ekkokammer.
Læringsnotatet skifter fra uge til uge, men vores instruktioner og skills ligger fast. Det er hele pointen med dem: Vi træffer de pædagogiske valg én gang og slipper for at tage stilling på ny i hver samtale. Men en fast opskrift gemmer også vores dårlige vaner. Har vi først bedt agenten om at rykke ud med den fulde forklaring ved det mindste tegn på tøven, sætter vi en pædagogisk kortslutning i system. Så måler agenten vores utålmodighed i stedet for vores faglige problem – uge efter uge.
Derfor må selve opskriften indimellem til eftersyn, og her kan agenten udmærket være med på værkstedet. Det betyder selvfølgelig ikke, at enhver hurtig opsummering skal følges op af dyb pædagogisk selvransagelse; man kan også reflektere så længe over sin studieteknik, at man aldrig får læst pensum. I sidste kapitel ser vi derfor på, hvordan vi vurderer, om selve arbejdsdelingen holder under studiets virkelige betingelser.
V. Dømmekraft gennem øvelse
At kende principperne fra kapitel I er ikke det samme som at kunne bruge dem en tirsdag aften, hvor en passage på side 14 nægter at give mening, og chatten står klar med en opsummering. Besværet kommer desværre ikke selv med en etiket, der fortæller os dets pædagogiske værdi. Samtidig er der også et liv uden for studiet, og nogle uger er pensum længere end ugen. Men en travl kalender sætter ikke hukommelsens eller læringens spilleregler ud af kraft. Den betyder blot, at vi ikke kan nå at vinde det hele hver gang.
Det er for at stå stærkere på sådan en tirsdag, at vi i kapitel III og IV har indrettet faste projekter, skills og agenter. Men ikke engang det mest velsmurte arbejdsrum kan træffe de pædagogiske valg én gang for alle. For ligesom en travl uge kan friste os til at skyde genvej uden om systemet, rummer selve systemet den modsatte fælde: at vi stoler så blindt på vores egen opsætning, at vi slår dømmekraften fra.
Når den gode arbejdsform bliver en sovepude
Et velsmurt projekt med skarpe instruktioner, skræddersyede skills og en agent, der fører logbog, kan give samme farlige tilfredsstillelse som en nyspidset blyant og en farvekodet læseplan: Systemet ser så fagligt ud, at man næsten føler, man allerede har lært stoffet. I indledningen så vi, hvordan en hurtig opsummering efterlod os med en tanke, der føltes fuldt møbleret, indtil vi selv skulle vise rundt i den til holdtimen. Et avanceret arbejdsrum kan skabe nøjagtig samme illusion – blot på et højere niveau. Når agenten stiller spørgsmål i tre runder, giver os præcise hints og til sidst roser vores svar, føles det unægtelig som hårdt fagligt arbejde. Men vi har måske bare udskiftet den førende dansepartner med et sæt avancerede støttehjul, som gør det umuligt at vælte undervejs.
Derfor må indledningens tre spørgsmål stilles mindst lige så skarpt til vores egen opsætning som til den hurtige opsummering: Hvilket arbejde udførte AI'en? Hvilket udførte vi? Og hvad kan vi bagefter? Hvis en nærmere granskning af sessionen viser, at agenten både udvalgte tekststedet, stillede tre ledende spørgsmål og hviskede os nøgleordet i øret, så snart vi tøvede, mens vores eget bidrag mest bestod i at udfylde de sidste tomme felter i dens ræsonnement – så har maskinen igen taget det tunge løft.
Det sidste spørgsmål, hvad kan vi bagefter?, deler sig derfor nu i to. Det ene spor handler om faget: Sidder stoffet faktisk fast, når vi lukker computeren og sidder til holdtimen uden agentens støttende stikord? Det andet spor handler om selve håndværket: Kan vi kigge kritisk på vores egne forsøg og opsætning og vurdere, om hjælpen er skruet rigtigt sammen? Et sådant arbejde med at indrette og justere sit faglige arbejde er i sig selv en øvelse i faglig dømmekraft.
At skrue på maskinen
En pædagogisk arbejdsdeling sidder sjældent i skabet i første hug; de gode intentioner skal også overleve mødet med hverdagen. På et kursus hos McDaniel, Einstein og Een (2021) lagde de studerende en plan for en ny læringsstrategi og gjorde status en uge eller to senere. En deltager ville bruge flashcards og fri genkaldelse over fem dage, men nåede kun genkaldelsen på tre af dagene og ikke for alle tekstens afsnit. Alligevel oplevede hun, at strategien trak hende væk fra genlæsningen, og lagde i sin refleksion en mere realistisk plan med tidligere flashcards og færre begreber ad gangen. Man bliver sjældent klogere på sine egne studievaner ved blot at sidde og føle efter i maven; et konkret gerningssted gør eftersynet lettere (Zimmerman 2002; Endres et al. 2021).
I vores eget arbejdsrum er det præcis dét spor, læringsnotatet giver os. Fordi notatet gemmer både vores rå forsøg, de hints vi fik undervejs, og agentens vurdering, kan vi efter et par uger åbne motorhjelmen og lave det samme eftersyn af vores egen maskine. Hvis logbogen viser, at vi kun kom i mål, fordi agentens hints faldt så tidligt, at de tog brodden af genkaldelsen, har vi fundet en fejl i selve opskriften. Så kan vi gå ind i vores skill og skrue ned for hjælpsomheden, for eksempel ved at kræve to selvstændige forsøg, før agenten må give et vink. Den ændring er samtidig en hypotese, vi kan teste i næste uge: Første forsøg bliver formentlig mere famlende, men til gengæld bør stoffet sidde bedre fast efter en pause. Omvendt kan eftersynet også pege et andet sted hen – måske viser en gennemgang af de svage svar, at vi ikke sejlede i selve begrebet, men blot snublede over uklare undersøgelsesbeskrivelser i teksterne. Uanset hvad diagnosen ender med, tvinger eftersynet os til at begrunde, hvorfor vi enten holder fast i vores arbejdsdeling eller skruer på instruktionen.
Arbejdet med arbejdsdelingen
Også når selve arbejdsformen skal ses efter i sømmene, kan agenten lave et produktivt forarbejde: Den kan trække mønstrene frem fra en måneds læringsnotater, så vores refleksion har noget konkret at bide i. Men hjælpen tipper over i skadelig offloading i det øjeblik, agenten også leverer en færdig og velformuleret begrundelse for, hvordan den vil forbedre sin egen metode – og vi blot læser diagnosen, nikker genkendende og trykker Gem. Her er det nemlig vores egen læring, der er pensum. Hvis vi lader AI stå for hele evalueringen af AI, kan vores skill sagtens blive bedre fra uge til uge, uden at vores egen dømmekraft har rykket sig en millimeter.
Arbejdet med at vælge, afprøve og revidere selve arbejdsdelingen kan vi kalde andenordensarbejde. Da vi oprindeligt indrettede vores projekt og vores skills, byggede vi dem på en bestemt antagelse om, hvad vi lærte af – for eksempel at vi altid bør definere de centrale begreber, før vi går i gang med at diskutere teksten. Laver vi kun et overfladisk eftersyn, tjekker vi måske bare, om agenten faktisk fulgte reglen, og om vi blev hurtigere til at definere begreberne. Så består metoden prøven, mens selve antagelsen bag den går fri. I det egentlige andenordensarbejde kommer vores egne pædagogiske begrundelser også på operationsbordet: Var det overhovedet definitionerne, der var vores problem til holdtimen, eller har vi bare bygget en meget effektiv maskine til at træne det forkerte? Her giver logbogens tidligere forsøg os et konkret grundlag at diskutere ud fra, og agenten kan få til opgave at spille djævelens advokat mod vores egne studievaner. Når vi bruger eftersynet sådan, retter vi ikke bare i en tekstfil i et projekt; vi får øje på vores egne foretrukne smuthuller, når et stof bliver svært. Vi skruer på agentens opskrift, men det er vores egen dømmekraft, der bliver kalibreret.
Pensum bliver næppe kortere, og dagene bliver ikke længere. Der vil stadig være tekster, man kun når et stykke ind i på egen hånd, og forklaringsforsøg, der holder i den ene ende og flosser i den anden. Nogle aftener bruger vi AI til at sy netop dén flossede ende sammen; andre aftener skal den bare hjælpe forberedelsen helskindet i mål inden kl. 22. I takt med at modellerne bliver stærkere, kan de løfte en stadigt større del af det arbejde for os – men vores egen hukommelse udkommer ikke i en ny version til næste år. Arbejdsdelingen er der stadig kun for, at det er os, der bliver klogere af arbejdet.
Indledningens sidste spørgsmål – hvad kan vi bagefter? – rummer derfor til sidst både faget og vores egen læring. Efter en god uge med agenten kan vi forklare validitet uden støttehjul; efter et helt semester kan vi også se i notaterne, hvilke hints vi har skruet ned for, hvilke øvelser vi har lagt om, og hvorfor. Faglig dømmekraft i en tid med AI handler i sidste ende om netop dét: at kunne mærke, hvornår maskinen bærer os frem, og hvornår den bare går turen for os.
Litteratur
Bjork, R. A. & Bjork, E. L. (1992). A new theory of disuse and an old theory of stimulus fluctuation. I A. F. Healy, S. M. Kosslyn & R. M. Shiffrin (red.), From learning processes to cognitive processes: Essays in honor of William K. Estes (bd. 2, s. 35–67). Erlbaum.
Bjork, R. A. & Bjork, E. L. (2020). Desirable difficulties in theory and practice. Journal of Applied Research in Memory and Cognition, 9(4), 475–479. https://doi.org/10.1016/j.jarmac.2020.09.003
Bjork, R. A., Dunlosky, J. & Kornell, N. (2013). Self-regulated learning: Beliefs, techniques, and illusions. Annual Review of Psychology, 64, 417–444. https://doi.org/10.1146/annurev-psych-113011-143823
Chi, M. T. H., de Leeuw, N., Chiu, M.-H. & LaVancher, C. (1994). Eliciting self-explanations improves understanding. Cognitive Science, 18(3), 439–477. https://doi.org/10.1207/s15516709cog1803_3
DeepSeek-AI (2026). DeepSeek-V4: Towards highly efficient million-token context intelligence. arXiv:2606.19348. https://arxiv.org/abs/2606.19348
Endres, T., Leber, J., Böttger, C., Rovers, S. & Renkl, A. (2021). Improving lifelong learning by fostering students' learning strategies at university. Psychology Learning & Teaching, 20(1), 144–160. https://doi.org/10.1177/1475725720952025
Hong, K., Troynikov, A. & Huber, J. (2025). Context rot: How increasing input tokens impacts LLM performance. Chroma Technical Report. https://research.trychroma.com/context-rot
Kalai, A. T., Nachum, O., Vempala, S. S. & Zhang, E. (2026). Evaluating large language models for accuracy incentivizes hallucinations. Nature, 653(8116), 1047–1051. https://doi.org/10.1038/s41586-026-10549-w
Kirk, R., Mediratta, I., Nalmpantis, C., Luketina, J., Hambro, E., Grefenstette, E. et al. (2023). Understanding the effects of RLHF on LLM generalisation and diversity. arXiv:2310.06452. https://arxiv.org/abs/2310.06452
Kornell, N., Hays, M. J. & Bjork, R. A. (2009). Unsuccessful retrieval attempts enhance subsequent learning. Journal of Experimental Psychology: Learning, Memory, and Cognition, 35(4), 989–998. https://doi.org/10.1037/a0015729
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F. et al. (2023). Lost in the middle: How language models use long contexts. arXiv:2307.03172. https://arxiv.org/abs/2307.03172
Lodge, J. M. & Loble, L. (2026). Artificial intelligence, cognitive offloading and implications for education. University of Technology Sydney. https://doi.org/10.71741/4pyxmbnjaq.31302475
Martin, A. J. & Evans, P. (2019). Load reduction instruction (LRI). I S. Tindall-Ford, S. Agostinho & J. Sweller (red.), Advances in cognitive load theory (s. 15–29). Routledge. https://doi.org/10.4324/9780429283895-2
McDaniel, M. A., Einstein, G. O. & Een, E. (2021). Training college students to use learning strategies: A framework and pilot course. Psychology Learning & Teaching, 20(3), 364–382. https://doi.org/10.1177/1475725721989489
Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C. L., Mishkin, P. et al. (2022). Training language models to follow instructions with human feedback. arXiv:2203.02155. https://arxiv.org/abs/2203.02155
Risko, E. F. & Gilbert, S. J. (2016). Cognitive offloading. Trends in Cognitive Sciences, 20(9), 676–688. https://doi.org/10.1016/j.tics.2016.07.002
Roediger, H. L. & Karpicke, J. D. (2006). Test-enhanced learning: Taking memory tests improves long-term retention. Psychological Science, 17(3), 249–255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
Rozenblit, L. & Keil, F. (2002). The misunderstood limits of folk science: An illusion of explanatory depth. Cognitive Science, 26(5), 521–562. https://doi.org/10.1207/s15516709cog2605_1
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R. et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548. https://arxiv.org/abs/2310.13548
Zhang, J., Yu, S., Chong, D., Sicilia, A., Tomz, M. R., Manning, C. D. et al. (2025). Verbalized sampling: How to mitigate mode collapse and unlock LLM diversity. arXiv:2510.01171. https://arxiv.org/abs/2510.01171
Zimmerman, B. J. (2002). Becoming a self-regulated learner: An overview. Theory Into Practice, 41(2), 64–70. https://doi.org/10.1207/s15430421tip4102_2

